Article publié le vendredi 13 novembre 2026 dans la catégorie Digital.
L’edge computing décentralisé désigne une manière d’organiser les ressources informatiques au plus près des lieux où les données sont produites. Au lieu d’envoyer systématiquement chaque flux vers un centre de données distant, plusieurs équipements locaux analysent, filtrent ou stockent une partie de l’information. Cette approche répond surtout aux contraintes de
temps réel, de connectivité et de confidentialité rencontrées avec l’IoT, les caméras, les machines et les véhicules connectés.
Définition du edge computing décentralisé
Traiter les données au plus près de leur source
L’edge computing consiste à placer du calcul et du stockage à proximité de la source de données : capteur, caméra, automate industriel, terminal mobile ou véhicule. Un nœud edge peut ainsi détecter localement une anomalie dans une image, agréger des mesures ou exécuter l’inférence d’un modèle d’intelligence artificielle.
Le principe n’exclut pas le cloud. Les données utiles, les résultats consolidés ou les historiques peuvent toujours y être transmis. La différence tient au fait que les décisions urgentes ne dépendent plus nécessairement d’un aller-retour réseau vers un site distant. Pour approfondir ce lien avec les objets connectés, consultez
le fonctionnement de l’edge computing avec l’IoT.
Répartir les ressources entre plusieurs nœuds autonomes
La dimension décentralisée ajoute une répartition des capacités entre plusieurs nœuds, souvent implantés sur différents sites. Chaque nœud peut continuer à traiter les flux dont il a la charge, avec une autonomie plus ou moins grande en cas de coupure réseau. Il ne s’agit donc pas seulement de rapprocher un serveur du terrain, mais de bâtir une
informatique distribuée sans point de traitement unique.
Cette autonomie reste encadrée : les règles métier, les logiciels et certains référentiels sont généralement administrés de façon centralisée. La décentralisation concerne surtout l’exécution opérationnelle locale.
Cloud centralisé, edge et modèle réparti : les différences
Le rôle des centres de données et du cloud
Dans un modèle de cloud computing centralisé, les applications et données sont principalement hébergées dans des centres de données mutualisés. Cette organisation facilite la consolidation des ressources, l’entraînement de modèles d’IA exigeants et l’analyse de grands volumes historiques. Elle suppose toutefois que les données traversent le réseau avant d’être traitées.
L’edge classique déplace certaines tâches vers la périphérie, tout en pouvant s’appuyer sur une infrastructure centrale. Une architecture décentralisée multiplie les sites de calcul et répartit aussi la capacité de décision.
Le cloud reste le bon niveau pour coordonner, archiver et entraîner ; l’edge traite ce qui exige proximité ou continuité. La comparaison détaillée est présentée dans
les différences entre edge computing et cloud computing.
| Modèle | Lieu principal du traitement | Usage caractéristique |
| Cloud centralisé | Centre de données distant | Analyse globale, stockage, entraînement IA |
| Edge | Équipement ou site proche du terrain | Filtrage local et réponse rapide |
| Edge décentralisé | Plusieurs nœuds locaux coordonnés | Décisions locales et continuité multi-sites |
Ce que la décentralisation change dans l’architecture
La décentralisation réduit la dépendance à un seul serveur ou à une connexion permanente. Les nœuds peuvent isoler une panne, basculer certaines tâches ou conserver temporairement les données. En contrepartie, l’architecture doit gérer des équipements hétérogènes, des versions logicielles différentes et des états de données parfois divergents.
La cohérence est souvent « éventuelle » : après une déconnexion, les répliques convergent lorsque la liaison est rétablie. Ce compromis est acceptable si une décision locale reste fiable sans disposer immédiatement de toutes les données du système.
Fonctionnement d’une infrastructure répartie
Capteurs, passerelles, serveurs locaux et appareils connectés
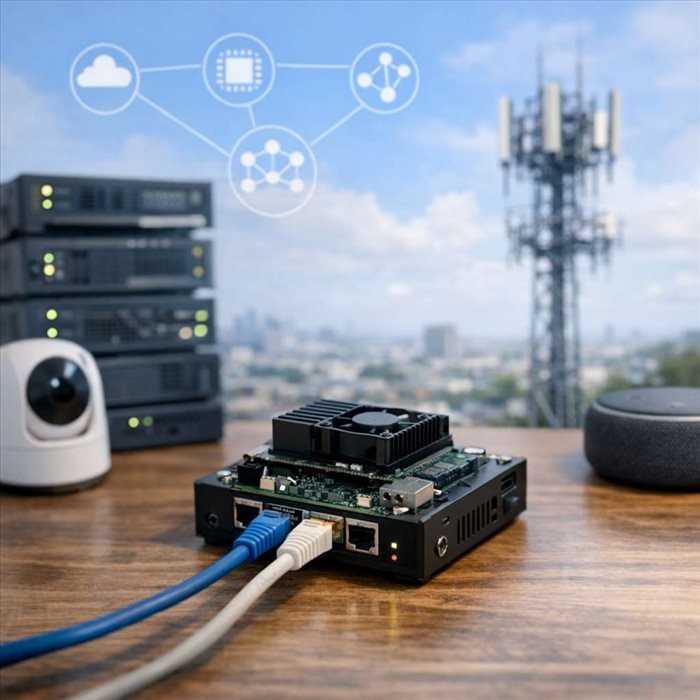
La chaîne commence par les sources de données. Une passerelle IoT relie les capteurs à un réseau, convertit éventuellement les protocoles et réalise un prétraitement : filtrage, agrégation, déduplication ou détection d’événements. Un serveur local, une appliance dédiée ou un ordinateur embarqué exécute ensuite les applications plus lourdes.
Les fonctions sont réparties selon la contrainte :
- capteur ou appareil : mesure et réaction très simple ;
- passerelle : collecte, normalisation et filtrage ;
- nœud local : analyse, IA et pilotage sur site ;
- cloud : supervision globale, archivage et entraînement des modèles.
Synchronisation des données et pilotage distribué
Les nœuds envoient périodiquement leurs résultats vers une plateforme centrale et reçoivent en retour des configurations ou mises à jour. Cette orchestration distribuée permet de déployer le même logiciel sur de nombreux sites. Les conteneurs facilitent l’emballage des applications ; des déclinaisons de Kubernetes peuvent orchestrer ces charges malgré des ressources limitées et des connexions instables. Voir
l’adaptation de Kubernetes aux environnements edge distribués.
Gains opérationnels attendus
Réduire la latence et améliorer la réactivité
La latence correspond au délai entre l’émission d’une donnée, son traitement et la réponse. Éviter un aller-retour vers le cloud réduit cette attente et limite l’exposition aux variations de réseau. C’est décisif lorsqu’une réponse doit intervenir pendant un processus : arrêter une machine, signaler un obstacle ou trier un produit.
Le traitement en temps réel ne signifie pas forcément instantané : le délai acceptable dépend de l’usage. Une alerte de maintenance peut tolérer quelques secondes, tandis qu’un contrôle de robot exige une réaction bien plus courte.
Renforcer la résilience, la confidentialité et la maîtrise des coûts réseau
Un site peut poursuivre des fonctions essentielles en cas de liaison dégradée avec le cloud. Cette tolérance aux pannes découle de l’autonomie locale, à condition que les scénarios de déconnexion soient prévus. Le prétraitement diminue aussi les volumes transférés : seules les anomalies, métadonnées ou séquences pertinentes remontent.
Enfin, garder certaines données localement améliore la maîtrise de leur emplacement et soutient la
souveraineté des données. Cela ne supprime pas les obligations de protection : les données sensibles restent à sécuriser sur chaque nœud.
Domaines où l’approche apporte le plus de valeur
Industrie, maintenance prédictive et robotique
Dans une usine, des nœuds locaux analysent vibrations, températures ou images de contrôle qualité. Ils peuvent détecter une dérive, avertir un opérateur ou adapter un robot sans attendre une réponse distante. Les données consolidées servent ensuite à suivre les tendances et à améliorer les modèles prédictifs.
Villes intelligentes, transport et véhicules connectés
Caméras, feux, stations de comptage et véhicules génèrent des flux continus. Les analyser près du terrain évite d’acheminer en permanence toutes les vidéos. Les réseaux 5G peuvent compléter cette organisation grâce à leur capacité et à leur faible latence ;
l’edge computing dans les réseaux 5G en précise les usages et enjeux.
Santé, commerce et sites isolés
Dans la santé, le traitement local peut limiter la circulation d’images ou de mesures sensibles. En magasin, il permet d’analyser localement l’état d’équipements ou l’affluence. Sur un navire, un chantier ou une installation énergétique isolée, il garantit surtout la continuité du traitement lorsque la connectivité est intermittente.
Limites et points de vigilance avant son adoption
Sécurité des équipements répartis et gestion des accès
Multiplier les nœuds augmente la surface d’attaque : ports réseau, interfaces d’administration, supports physiques et comptes de service. Chaque appareil doit être inventorié, authentifié et maintenu. La gestion des identités et des accès applique le principe du moindre privilège ; la segmentation réseau limite la propagation d’une compromission entre zones.
Un nœud local non mis à jour peut annuler le bénéfice de confidentialité recherché. Chiffrement, journalisation et procédures de révocation sont donc indispensables.
Complexité du déploiement, de la maintenance et de la gouvernance des données
Le coût ne se limite pas au matériel. Il faut superviser à distance des sites nombreux, gérer les pannes, les mises à jour et les écarts de configuration. La gouvernance doit aussi préciser quelles données restent sur place, combien de temps elles sont conservées et lesquelles sont synchronisées.
Avant de déployer, il convient d’identifier les flux réellement sensibles à la latence ou à la bande passante.
Le choix d’une architecture edge en entreprise dépend ensuite du niveau d’autonomie attendu, des contraintes réseau et des exigences de sécurité.
Le point à retenir pour vos projets connectés
L’edge computing décentralisé rapproche les capacités de traitement du terrain tout en répartissant l’exécution entre plusieurs sites. Son intérêt apparaît lorsque la rapidité de réponse, la continuité d’activité ou le contrôle des flux priment sur une centralisation complète. Il ne remplace pas le cloud : une architecture efficace combine généralement
autonomie locale pour les opérations critiques et coordination centrale pour l’analyse, l’administration et l’évolution des services.
Cette approche demande toutefois une discipline technique : supervision des nœuds, mises à jour fiables, contrôle des accès et règles claires de synchronisation. Le bon point de départ consiste à identifier les processus pour lesquels une
décision proche de la source apporte un bénéfice concret, puis à dimensionner l’infrastructure selon les contraintes réelles du terrain.
Les questions fréquentes
L’edge computing décentralisé est-il la même chose que la blockchain ?
Non. La blockchain est une technologie de registre partagé qui valide et conserve des transactions selon des mécanismes de consensus. L’edge décentralisé répartit surtout les ressources de calcul et de stockage entre plusieurs emplacements. Les deux approches peuvent coexister, mais
l’une ne nécessite pas l’autre.
Un système peut-il fonctionner sans connexion au cloud ?
Oui, pour les fonctions prévues localement. Un nœud peut continuer à collecter des données, déclencher une alerte ou piloter un équipement pendant une interruption réseau. En revanche, les remontées centralisées, les sauvegardes et certaines mises à jour attendront le retour de la connexion. Cette autonomie doit être définie dès la conception.
Pourquoi l’intelligence artificielle est-elle souvent utilisée en périphérie ?
Elle permet d’exécuter localement l’inférence d’un modèle, par exemple reconnaître un défaut sur une image ou détecter une situation inhabituelle dans un flux de capteurs. Seul le résultat pertinent peut ensuite être transmis.
L’entraînement du modèle, plus exigeant en ressources, reste souvent réalisé dans une infrastructure centrale.
Quels équipements peuvent devenir des nœuds edge ?
Un serveur installé sur site, une passerelle industrielle, un boîtier réseau, un ordinateur embarqué ou parfois un appareil connecté suffisamment puissant peuvent remplir ce rôle. Le choix dépend de la puissance de calcul, du stockage disponible, de l’environnement physique et des exigences de disponibilité. Un équipement edge doit aussi pouvoir être administré et sécurisé à distance.
Dans quels cas cette architecture n’est-elle pas nécessaire ?
Elle apporte peu lorsque les données sont peu volumineuses, que les délais de réponse sont larges et qu’une connexion fiable au cloud est disponible. Centraliser peut alors simplifier l’exploitation. L’approche répartie devient pertinente lorsque
la décision locale ou la continuité de service justifie sa complexité supplémentaire.